Am 3. September 2024 schlug Jeremy Howard, Mitgründer von Answer.AI, eine neue Datei für Websites vor: die llms.txt. Die Idee war schlicht. Sprachmodelle tun sich mit HTML voller Navigation und Cookie-Banner schwer, also legt man ihnen im Root eine kompakte Markdown-Datei hin, die erklärt, worum es auf der Site geht und wo die wichtigen Inhalte liegen. Zwei Jahre später hat laut Ahrefs gut jede vierte untersuchte Domain so eine Datei, Yoast erzeugt sie auf Knopfdruck, und für Magento gibt es kostenpflichtige Generatoren. Gleichzeitig sagt Google, dass Google Search die Datei ignoriert. Wir haben recherchiert, was dahintersteckt, und zeigen, wofür llms.txt wirklich taugt und wofür nicht.
Was eine llms.txt ist und wie sie aufgebaut ist
Die llms.txt liegt unter /llms.txt und ist reines Markdown. Die Spezifikation auf llmstxt.org gibt eine feste Reihenfolge vor, verlangt aber nur ein einziges Element: eine H1 mit dem Namen der Website oder des Projekts. Alles andere ist optional.
- H1 mit dem Namen (Pflicht)
- Blockquote mit einer kurzen Zusammenfassung
- beliebige Absätze oder Listen ohne Überschrift, etwa Hinweise zur Nutzung
- H2-Abschnitte mit Linklisten im Format
[Name](URL): Notiz
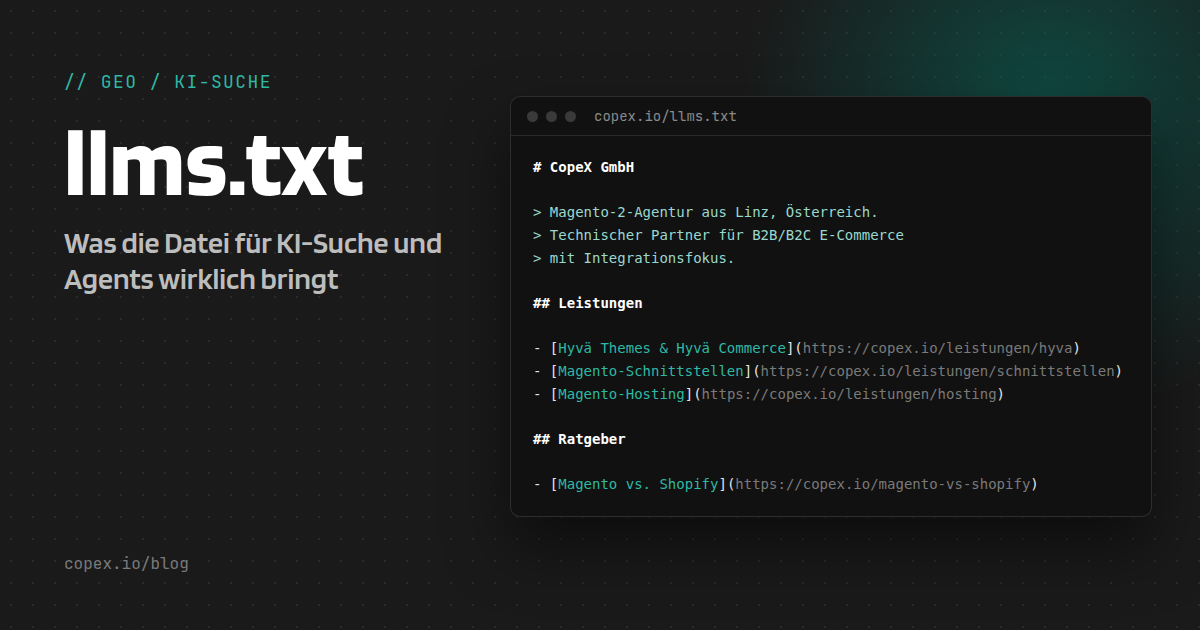
So sieht das aus, verkürzt aus unserer eigenen Datei unter copex.io/llms.txt:
# CopeX GmbH

> Magento-2-Agentur aus Linz, Österreich. Technischer Partner für B2B/B2C E-Commerce mit Integrationsfokus.

## Leistungen

- [Hyvä Themes & Hyvä Commerce](https://copex.io/leistungen/hyva): Hyvä Silver Partner aus Linz. Wir migrieren bestehende Magento-Shops auf Hyvä …
- [Magento-Hosting & Managed Server](https://copex.io/leistungen/hosting): Ein auf Magento optimierter, von uns betreuter Server …

## Ratgeber

- [Magento vs. Shopify](https://copex.io/magento-vs-shopify): Plattformvergleich mit Empfehlungs-Matrix und Break-Even-Rechnung
Im August 2026 erschien Version 2 der Spezifikation, und die räumt mit einigem auf, was in älteren Anleitungen noch steht. Das Tool llms_txt2ctx, das aus der llms.txt Kontextdateien wie llms-ctx.txt erzeugte, ist nicht mehr Teil des Vorschlags. Damit verliert auch der Abschnitt „Optional“ seine Sonderrolle und ist nur noch eine Konvention für Links, die ein Agent bei knappem Kontext überspringen kann. Neu geregelt ist, dass eine llms.txt in einem Unterpfad wie /docs/llms.txt für alle Seiten darunter gilt. Gibt es mehrere, gewinnt die spezifischste. Markdown-Versionen einzelner Seiten heißen seite.html.md oder seite.md und lassen sich per <link rel="alternate" type="text/markdown"> auffinden.
Und die oft zitierte llms-full.txt? Die steht in der Spezifikation gar nicht. Sie stammt von Mintlify, das im November 2024 llms.txt und llms-full.txt automatisch für alle bei Mintlify gehosteten Dokumentationen ausgerollt hat. Die llms-full.txt enthält den kompletten Inhalt als einen großen Markdown-Block. Verbreitet ist sie trotzdem.
llms.txt, robots.txt und sitemap.xml: drei Dateien, drei Aufgaben
Weil alle drei im Root liegen, werden sie gern verwechselt. Dabei überschneiden sie sich kaum.
| Datei | Zweck | Sperrt etwas? | Wer wertet aus |
|---|---|---|---|
robots.txt | regelt, was Crawler abrufen dürfen | ja | alle seriösen Crawler, auch GPTBot, ClaudeBot, PerplexityBot |
sitemap.xml | listet alle indexierbaren URLs | nein | Suchmaschinen |
llms.txt | kuratierte Leseempfehlung in Markdown | nein | einzelne Agents und Tools, kein großer Crawler offiziell |
Entscheidend ist die Spalte „Sperrt etwas?“. Wer nicht möchte, dass seine Inhalte in KI-Trainingsdaten landen, erreicht mit einer llms.txt gar nichts. Dafür bleibt die robots.txt zuständig. Die Crawler-Dokumentationen der großen KI-Anbieter nennen ausschließlich robots.txt als Steuerung. Die llms.txt kommt dort nicht vor.
Eine Sitemap ersetzt die llms.txt auch nicht, und das sagt die Spezifikation selbst. Eine Sitemap listet jede indexierbare Seite, bei einem Shop mit 20.000 Produkten also 20.000 URLs ohne jede Beschreibung. Das sprengt jedes Kontextfenster. Die llms.txt ist das Gegenteil davon: wenige Links, ausgewählt von jemandem, der weiß, was wichtig ist.
Was Google, OpenAI und Anthropic zu llms.txt sagen
Begeistert ist keiner davon. Google ist am deutlichsten. Im AI-Optimization-Guide für die Google-Suche (Stand 10. Juli 2026) steht, man brauche keine neuen maschinenlesbaren Dateien, um in der Suche aufzutauchen. Wörtlich heißt es dort: „For Google Search, you can ignore tactics like ‚chunking‘ content, creating unnecessary AI text files (like llms.txt) …“. An anderer Stelle schreibt Google, solche Dateien würden der Sichtbarkeit weder helfen noch schaden, weil Google Search sie ignoriert.
Das passt zu dem, was John Mueller von Google schon im April 2025 auf Reddit geschrieben hat. Seiner Kenntnis nach habe keiner der KI-Dienste gesagt, dass er llms.txt nutzt, und in den Server-Logs sehe man, dass sie nicht einmal danach fragen. Er verglich die Datei mit dem Keywords-Meta-Tag. Wer schon länger SEO macht, weiß, dass das kein Kompliment ist.
Ganz einheitlich ist Google allerdings nicht. Spätestens seit Mai 2026 dokumentiert das Chrome-Team einen Lighthouse-Audit in der Kategorie „Agentic Browsing“, der nach einer llms.txt schaut. Fehlt die Datei, gilt der Audit als „Not Applicable“, weil sie laut Doku optional ist. Fehlschlagen kann er nur, wenn der Server beim Abruf einen Fehler liefert. Mit Ranking hat das nichts zu tun. Es zeigt eher, dass Chrome die Datei für Browser-Agents im Blick hat.
Von OpenAI, Anthropic oder Perplexity gibt es keine Aussage, dass ihre Crawler oder ihre Suche die llms.txt auswerten. Bemerkenswert ist, dass alle drei selbst eine llms.txt für ihre Entwickler-Dokumentation anbieten, Anthropic unter platform.claude.com/llms.txt, OpenAI unter developers.openai.com/llms.txt. Die Dateien richten sich an Entwickler und deren Coding-Agents.
Was die Server-Logs zeigen
Wer wissen will, ob KI-Crawler eine llms.txt lesen, schaut am besten in die Logs. Genau das hat Ahrefs im Juni 2026 im großen Stil getan. Untersucht wurden 137.210 Domains aus Ahrefs Web Analytics, die im Mai 2026 Traffic hatten.
| Kennzahl (Ahrefs, Mai 2026) | Wert |
|---|---|
| Domains mit llms.txt | 28 % (rund 38.000) |
| davon im ganzen Monat kein einziger Abruf | 97 % |
| Anteil KI-Bots an den Abrufen der übrigen 3 % | 19,5 % |
Ahrefs selbst fasst das trocken zusammen: „If you publish an llms.txt file today, the most likely outcome by far is that nothing ever fetches it.“ Eine kleinere Auswertung von EZY.ai über 83 Websites kommt zu einem ähnlichen Bild. Zwischen Ende April und Mitte Juli 2026 riefen die Crawler von OpenAI dort die llms.txt siebenmal ab, die robots.txt 3.990 Mal. Bei ClaudeBot stand es 9 zu 3.120.
SE Ranking hat sich rund 300.000 Domains angesehen und nach einem Zusammenhang zwischen llms.txt und Zitierungen in KI-Antworten gesucht. Gefunden wurde keiner. Die 28 % bei Ahrefs und die gut 10 % bei SE Ranking zeigen nebenbei, wie stark solche Verbreitungszahlen von der Stichprobe abhängen. Ahrefs nennt seine Zahl ausdrücklich eine Obergrenze.
Unsere Einschätzung: Wer eine llms.txt anlegt, weil eine Agentur „mehr Sichtbarkeit in ChatGPT“ verspricht, kauft ein Versprechen ohne Beleg.
Wofür llms.txt wirklich nützlich ist
Die Spezifikation selbst ist da ehrlicher als manches Marketing. Sie beschreibt die llms.txt als Hilfe für die Inferenz, nicht für das Training, also für den Moment, in dem ein Agent gezielt Informationen sucht. Am stärksten genutzt werde sie bei Software-Dokumentation, wo Coding-Agents den Links folgen.
LangChain bietet mit mcpdoc einen MCP-Server, der Claude Code, Cursor oder Windsurf ein Werkzeug gibt, um llms.txt-Dateien aus einer festgelegten Liste abzurufen und den Links darin zu folgen. Der Agent liest dann die aktuelle Doku statt eines veralteten Forenbeitrags. Hyvä hat unter docs.hyva.io/llms.txt eine llms.txt, Cloudflare und Stripe ebenfalls. Die Developer-Doku von Adobe Commerce hatte beim Schreiben dieses Artikels keine (404). Wie solche MCP-Server im Magento-Umfeld aussehen, haben wir in unserem Überblick über MCP-Server für Magento beschrieben.
Für einen Onlineshop sieht die Rechnung anders aus. Ein KI-Agent, der für einen Kunden Bohrmaschinen vergleicht, braucht Preis, Verfügbarkeit, Versandkosten und eine GTIN, und zwar auf der Produktseite in dem Moment, in dem er sie aufruft. Eine llms.txt mit zwanzig Links auf Kategorieseiten hilft ihm dabei kaum. Was wirklich zählt, haben wir im Artikel über strukturierte Daten für KI-Preisvergleiche aufgeschrieben: vollständiges Schema.org-Markup, das live aus Magento kommt.
Wie wir llms.txt auf copex.io einsetzen
Seit dem Relaunch unserer Website auf Astro haben wir eine llms.txt, dazu eine llms-full.txt mit Kurzfassungen aller Leistungen, Module, Referenzen und der 20 neuesten Blogartikel. Beide Dateien schreibt bei uns niemand von Hand. Sie entstehen beim Build der Astro-Seite aus denselben Inhalten wie die HTML-Seiten, über zwei Endpunkte, src/pages/llms.txt.ts und src/pages/llms-full.txt.ts. Kommt eine neue Leistung oder Referenz dazu, steht sie beim nächsten Deploy automatisch in der Datei. Mehr zum Aufbau der Seite steht im Artikel Von WordPress zu Astro.
Für uns zählt vor allem eins: Die Datei muss sich selbst aktualisieren. Eine llms.txt, die jemand einmal von Hand anlegt und dann vergisst, ist nach dem nächsten Relaunch voller toter Links. Bei einem Magento-Shop mit wechselndem Sortiment passiert das noch schneller. Wenn schon, dann generiert.
Für Magento gibt es dafür fertige Module, etwa den LLMs TXT Generator von Magefan, der pro Store View eine Datei erzeugt und sie per Cronjob aktualisiert. Ob sich das für deinen Shop lohnt, ist eine ehrliche Frage. Der Aufwand ist klein, der messbare Nutzen derzeit auch. Wir würden das Budget zuerst in sauberes Produkt-Markup, schnelle Seiten und eine durchdachte technische Suchmaschinenoptimierung stecken. Die llms.txt kommt danach, als günstige Wette darauf, dass Agents sie in Zukunft häufiger lesen.
Was du als nächstes tun kannst
Wenn du überlegst, für deinen Shop eine llms.txt anzulegen, helfen zwei pragmatische Schritte:
- Logs prüfen: Schau in deinen Server-Logs nach, ob GPTBot, ClaudeBot oder PerplexityBot überhaupt bei dir vorbeikommen und welche URLs sie abrufen. Hast du schon eine llms.txt, zeigt dir derselbe Blick, ob sie jemand liest.
- Grundlagen zuerst: Prüfe eine Produktseite im Rich Results Test von Google, ob Preis und GTIN im Markup stehen. Wenn nicht, ist das die größere Baustelle. Wir helfen dir bei beidem, ob Markup oder generierte llms.txt: office@copex.io oder über unser Kontaktformular.
Verwandte Themen aus unserem Blog: Strukturierte Daten für KI-Preisvergleiche, MCP-Server für Magento, Agent-to-Agent Commerce.
Quellen / Weiterlesen
- llmstxt.org: Spezifikation, Version 2 (August 2026), und die Änderungen gegenüber Version 1
- answer.ai: ursprünglicher Vorschlag von Jeremy Howard, 3. September 2024
- developers.google.com: AI-Optimization-Guide für die Google-Suche, Stand 10. Juli 2026
- developer.chrome.com: Lighthouse-Audit „llms.txt“ in der Kategorie Agentic Browsing
- ahrefs.com: Studie zu llms.txt mit 137.210 Domains, 15. Juni 2026
- ezy.ai: Log-Auswertung von 83 Websites, April bis Juli 2026
- searchenginejournal.com: John Mueller vergleicht llms.txt mit dem Keywords-Meta-Tag
- seranking.com: Auswertung von rund 300.000 Domains zu llms.txt und KI-Zitierungen
- mintlify.com: Einführung von llms.txt und llms-full.txt bei Mintlify, November 2024
- github.com/langchain-ai/mcpdoc: MCP-Server für llms.txt-Dateien
Und ja, auch dieser Artikel steht automatisch in unserer llms.txt. Ob ihn dort jemand liest, verraten uns die Logs.